变分自编码器(Variational AutoEncoder, VAE)
变分自编码器(Variational AutoEncoder, VAE)
VAE的核心目的:构建一个结构化的潜空间,用于数据生成
01 从 AE 到 VAE
自编码器(AutoEncoder, AE)通过编码器将高维输入数据 \(x\) 压缩成低维的潜空间(latent space)中的向量 \(z\),解码器再试图从 \(z\) 中重建原始数据 \(\hat{x}\)。
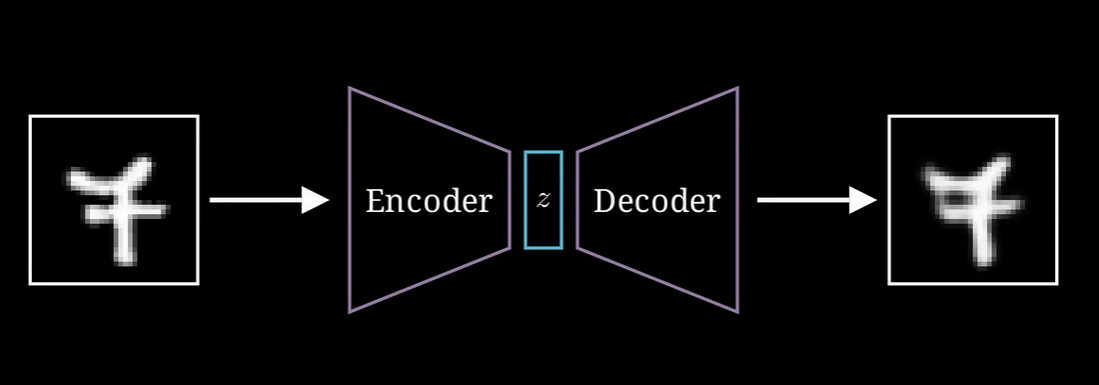
自编码器将观测数据直接映射到潜空间中的一点。 虽然经训练后,观测数据的分布通常会在潜空间中形成聚类映射,但是:
- 潜空间分布不规则,盲目从潜空间中采样极可能落入空白编码区域(即未对应任何有效观测数据的潜空间点),从而产生无意义的输出;
- 潜空间结构不连续,点与点之间的迁移没有规律,即使在真实数据对应的潜向量“附近”采样,由于缺乏对“附近”度量的可靠依据,采样得到的潜点通常无法重建出与原始输入数据语义相似或结构一致的有效输出。
因此,我们希望对潜空间进行规范,构建一个 Organized Latent Space。
02 VAE的原理
VAE 将观测数据 $x$ 视为由潜变量 $z$ 生成,使用一个神经网络(decoder)来学习从潜变量 $z$ 到真实数据 $x$ 的概率映射(条件概率 $p_\theta(x|z)$)。 如果这个网络被训练好,并且我们知道潜变量的先验分布 $p(z)$,我们就能从潜空间中重建观测空间的分布,即
\[p_\theta(x)=\int_z p_\theta(x|z) p(z) dz\]通常,条件概率 $p_\theta(x|z)$ 建模为高维的、各维独立的高斯分布,即decoder输出 \(x\) 每一维度的均值和方差 (方差也通常设为定值,则decoder只输出均值),即
\[p_\theta(x|z)=\mathcal{N}(x;\mu_\theta(z),\sigma^2I)\]以上两个式子的理论依据是将观测数据的分布建模为无限高斯混合模型, 每个高斯核( $p_\theta(x|z)$ )的权重即先验分布 $p(z)$ 的概率密度。
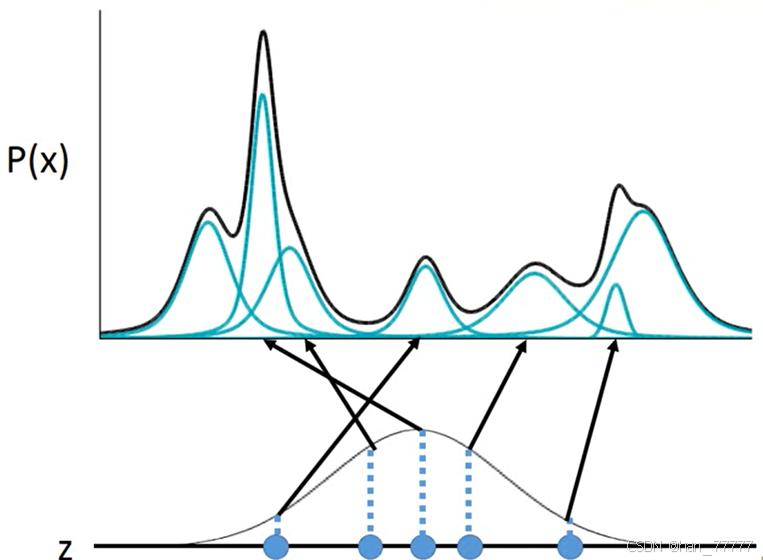
接下来就是如何训练的问题了。一个自然的想法是从先验分布中 Monte Carlo 采样,得到 $p_\theta(x)$ 后对训练数据最大似然,即
\[\theta^*=\arg\max_{\theta}\sum_i p_\theta(x^{(i)})\]然而这样效率很低,因为每次都要在整个空间中做采样,方差很大,优化过程难以收敛。 更合理的做法是在后验分布 $p_\theta(z|x^{(i)})$ 中采样(这里的下标 $\theta$ 表示后验分布由decoder参数决定, 先验分布已被指定为 $\mathcal{N}(0,I)$,重建的数据分布也由 $\theta$ 确定, 根据贝叶斯公式 $p_\theta(x,z)=p_\theta(x|z)p(z)=p_\theta(z|x)p_\theta(x)$ 易知后验分布也随之确定),得到更多有效样本。
然而,后验分布 $p_\theta(z|x^{(i)})$ 是未知的(事实上,如果我们能知道后验概率,那么依据贝叶斯公式就能直接得到 $p_\theta (x)$ 了, 也就是说,寻找重建的数据分布本质上与寻找后验分布等价),因此我们使用一个神经网络(encoder)来近似,即
\[q_\phi(z|x)=\mathcal{N}(z;\mu_\phi(x),\sigma^2_\phi(x))\]潜空间的后验分布也被建模为单一高斯分布。(同样的道理,在encoder的视角下潜空间的分布也被建模为混合高斯模型)
我们的学习目标依旧是:最大化观测数据 $x^{(i)}$ 的(对数)边际似然, 但有了近似后验概率 $q_\phi(z|x)$ ,我们现在可以在这个分布下计算该似然
\[\begin{align*} \log p_\theta(x^{(i)})&=\log p_\theta(x^{(i)})\int q_\phi(z|x^{(i)})dz\\\\ &=\mathbb{E}_{q_\phi(z|x^{(i)})}\left[\log p_\theta(x^{(i)})\right]\\\\ &=\mathbb{E}_{q_\phi(z|x^{(i)})}\left[\log \frac{p_\theta(x^{(i)}|z)p(z)}{p_\theta(z|x^{(i)})}\right]\\\\ &=\mathbb{E}_{q_\phi(z|x^{(i)})}\left[\log \frac{p_\theta(x^{(i)}|z)p(z)}{p_\theta(z|x^{(i)})}\frac{q_\phi(z|x^{(i)})}{q_\phi(z|x^{(i)})}\right]\\\\ &=\mathbb{E}_{q_\phi(z|x^{(i)})}\left[\log \frac{p_\theta(x^{(i)}|z)p(z)}{q_\phi(z|x^{(i)})}\right]+\mathbb{E}_{q_\phi(z|x^{(i)})}\left[\log \frac{q_\phi(z|x^{(i)})}{p_\theta(z|x^{(i)})}\right]\\\\ &=\mathbb{E}_{q_\phi(z|x^{(i)})}\left[\log \frac{p_\theta(x^{(i)}|z)p(z)}{q_\phi(z|x^{(i)})}\right]+D_{KL}\left(q_\phi(z|x^{(i)}) ||p_\theta(z|x^{(i)})\right) \end{align*}\]上式右边第二项是近似后验分布 $q_\phi(z|x)$ 和真实后验分布 $p_\theta(z|x^{(i)})$ 的 KL 散度,恒大于等于零。 因此,右边第一项是我们的优化目标观测数据对数似然的一个下界,我们称为 ELBO(Evidence Lower BOund),在 VAE 中,这正是我们的实际损失值定义。
下面我们说明为什么最大化 ELBO 就能最大化 $\log p_\theta(x^{(i)})$ :
1. VAE 的“异步优化”视角
假设我们固定 decoder 参数 $\theta$ ,那么 $\log p_\theta(x^{(i)})$ 也随之被固定, 此时增大 ELBO 等价于减小 $D_{KL}\left(q_\phi(z|x^{(i)}) ||p_\theta(z|x^{(i)})\right)$ 。 即优化过程可以解释为:通过调整 $\phi$ 使得编码器 $q_\phi(z|x)$ 更接近真实后验分布 $p_\theta(z|x^{(i)})$, 从而使得 ELBO 成为 $\log p_\theta(x^{(i)})$ 一个更紧致的下界。
接着固定 encoder 参数 $\phi$ ,优化 decoder 参数 $\theta$ 。 因为 ELBO 与似然目标 $\log p_\theta(x^{(i)})$ 足够接近,因此提升 ELBO 也会提升 $\log p_\theta(x^{(i)})$ 。 虽然另一方面, $D_{KL}\left(q_\phi(z|x^{(i)}) ||p_\theta(z|x^{(i)})\right)$ 也会同时受到影响, 但是它若增大则会直接增大 $\log p_\theta(x^{(i)})$ ,它若减小则进一步使 $\log p_\theta(x^{(i)})$ 的下界 ELBO 变紧。
循环上述的异步优化过程,ELBO 不断提升–>变紧–>提升–>变紧……,$D_{KL}\left(q_\phi(z|x^{(i)}) ||p_\theta(z|x^{(i)})\right)$ 也不断更新以适应新的 $\theta$ , 从而保证了 $\log p_\theta(x^{(i)})$ 稳定提升。
然而,实际训练中,$\theta$ 和 $\phi$ 其实是同步优化的,但是这可以近似看成上述异步优化两个步骤都只迭代一次的特殊情形。
以上的推断实际上隐含了一个条件:ELBO 能够持续提升。要理解这一点,我们需要审视 ELBO 的含义。
2. ELBO 的分解
展开 ELBO,可以将 ELBO 分解为重构损失项和 KL 正则项
\[\begin{align*}ELBO&=\mathbb{E}_{q_\phi(z|x^{(i)})}\left[\log p_\theta(x^{(i)}|z) + \log \frac{p(z)}{q_\phi(z|x^{(i)})}\right]\\\\&=\mathbb{E}_ {q_\phi(z|x^{(i)})} \left[ \log p_\theta(x^{(i)}|z) \right]-D_{KL}\left( q_\phi(z|x^{(i)})||p(z)\right)\end{align*}\]第一项表示在近似后验分布中采样得到的似然估计,指导模型学习真实观测数据的分布, 第二项是近似后验分布和先验分布的 KL 散度,规范后验分布的形状,从而规范潜空间的分布。
- 优化 $\phi$ (编码器):主要受重构精度和正则项驱动,驱使 $q_\phi(z|x)$ 更好地拟合当前 $\theta$ 下的后验
- 优化 $\theta$ (解码器):主要由重构项主导,鼓励解码器从 $z$ 重建 $x$
从结论出发,另一种理解方式可参考:https://cloud.tencent.com/developer/article/2559024。 大致理解为:如果没有正则项,模型为了更好地重构数据 $x^{i}$ ,会让方差往0靠近,只学均值,从而退化为AE。所以正则项就是让后验往标准正态分布学习。
03 实现 VAE
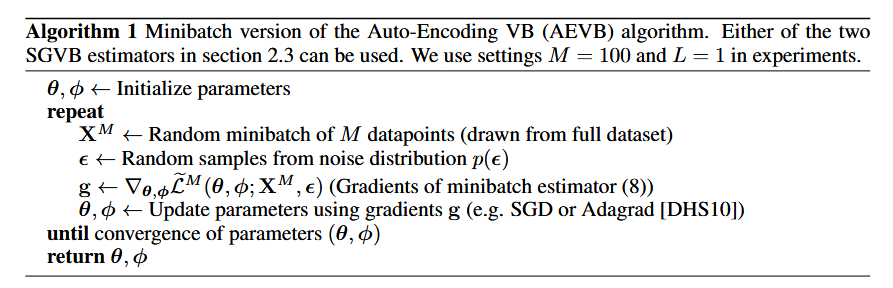
在计算 ELBO 关于 $\theta$ 和 $\phi$ 的梯度时,
重构项可以采用蒙特卡洛采样计算:
\[\mathbb{E}_ {q_\phi(z|x^{(i)})} \left[ \log p_\theta(x^{(i)}|z) \right]\approx\frac{1}{L}\sum_{l=1}^L\log p_\theta(x^{(i)}|z^{(l)})\]因为 SGD 的批次平均已提供足够的随机性,因此通常取 $L=1$。进一步,
\[\log p_\theta(x^{(i)}|z) =\log\left( \frac{1}{2\pi\sigma^2}\exp\left( -\frac{||x^{(i)}-\mu_\theta(z)||^2}{2\sigma^2} \right) \right)=-\frac{1}{2\sigma^2}||x^{(i)}-\mu_\theta(z)||^2-\log(2\pi\sigma^2)+C\]即最大化 $\mathbb{E}_ {q_\phi(z|x^{(i)})} \left[ \log p_\theta(x|z) \right]$ 等价于最小化 $\mathbb{E}_ {q_\phi(z|x^{(i)})} \left[||x^{(i)}-\mu_\theta(z)||^2\right]$ , 即重构损失可用均方误差(MSE)代替。
正则项 因为 $p(z)\sim\mathcal{N}(0,I)$,$q_\phi(z|x)\sim\mathcal{N}(\mu_\phi(x),\sigma^2_\phi(x))$,所以有封闭解:
\[D_{KL}\left( q_\phi(z|x^{(i)})||p(z)\right)=\frac{1}{2}\left(\mu_\phi^2(x^{(i)})+\sigma_\phi^2(x^{(i)})-\log\sigma_\phi^2(x^{(i)})-1\right)\]采样是个不可微的操作,因此使用重参数化(reparameterization trick)的方法,取外部参数 $\epsilon\sim\mathcal{N}(0,I)$,$z$ 通过
\[z=\mu_\phi(x^{(i)})+\epsilon*\sigma_\phi(x^{(i)})\]得到。